今天在使用查询程序时发现以下sql语句很慢,我一步步去掉很可能影响整度的部分,主要是几个count()子查询,然后发现速度就是因为这几个count()引起的。
select a.*,
       (select sum(e.zau11_gmqty)
          from zau11 e
         where a.zau10_slip_no = e.zau11_slip_no) as mold_count,
       (select d.yy010_name
          from yy010 d
         where a.zau10_sys_user = d.yy010_user_id) as apply_user_name,
       (select oa040_status_name_a
          from oa040 c
         where c.oa040_status_id = a.zau10_status) as status_name,
       (select yy010_name
          from yy010 b
         where b.yy010_user_id = a.zau10_next_man
           and b.yy010_del_flag = 'n') as next_man_name,
       (select e.md010_explain
          from md010 e
         where a.zau10_kind = e.md010_mold_sort) as kind_name,
       (select f.md010_explain
          from md010 f
         where a.zau10_role_mtr = f.md010_mold_sort) as role_mtr_name,
       (select count(*)
          from zam11 g, zam10 h
         where g.zam11_zam10_slip_no = h.zam10_slip_no
           and h.zam10_status in ('apply', 'cyes', 'end')
           and g.zam11_model_slip_no = a.zau10_slip_no) as cnt1,
       (select count(*)
          from zan11 i, zan10 j
         where i.zan11_zan10_slip_no = j.zan10_slip_no
           and j.zan10_status in ('apply', 'cyes', 'end')
           and i.zan11_mold_slip_no = a.zau10_slip_no) as cnt2
  from zau10 a
 order by zau10_slip_no desc
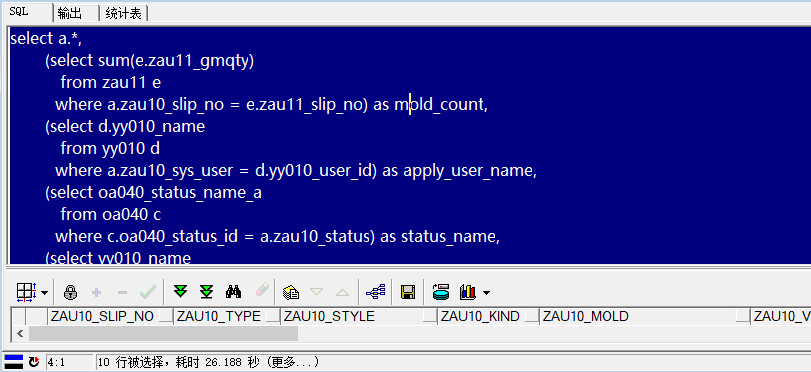
以下就是原sql查询所消耗的时间为26.188秒,这种查询很慢的sql必须要优化,26秒太长了,实际上sql超过10秒都算比较慢的了
我优化了一下sql的写法:
SELECT a.*,
       NVL(mc.mold_count, 0) AS mold_count,
       (SELECT d.yy010_name
          FROM yy010 d
         WHERE a.zau10_sys_user = d.yy010_user_id) AS apply_user_name,
       (SELECT c.oa040_status_name_a
          FROM oa040 c
         WHERE c.oa040_status_id = a.zau10_status) AS status_name,
       (SELECT b.yy010_name
          FROM yy010 b
         WHERE b.yy010_user_id = a.zau10_next_man
           AND b.yy010_del_flag = 'n') AS next_man_name,
       (SELECT e.md010_explain
          FROM md010 e
         WHERE a.zau10_kind = e.md010_mold_sort) AS kind_name,
       (SELECT f.md010_explain
          FROM md010 f
         WHERE a.zau10_role_mtr = f.md010_mold_sort) AS role_mtr_name,
       NVL(c1.cnt1, 0) AS cnt1,
       NVL(c2.cnt2, 0) AS cnt2
  FROM zau10 a
  LEFT JOIN (SELECT zau11_slip_no, SUM(zau11_gmqty) AS mold_count
               FROM zau11
              GROUP BY zau11_slip_no) mc ON a.zau10_slip_no =
                                            mc.zau11_slip_no
  LEFT JOIN (SELECT g.zam11_model_slip_no, COUNT(*) AS cnt1
               FROM zam11 g
               JOIN zam10 h ON g.zam11_zam10_slip_no = h.zam10_slip_no
              WHERE h.zam10_status IN ('apply', 'cyes', 'end')
              GROUP BY g.zam11_model_slip_no) c1 ON a.zau10_slip_no =
                                                    c1.zam11_model_slip_no
  LEFT JOIN (SELECT i.zan11_mold_slip_no, COUNT(*) AS cnt2
               FROM zan11 i
               JOIN zan10 j ON i.zan11_zan10_slip_no = j.zan10_slip_no
              WHERE j.zan10_status IN ('apply', 'cyes', 'end')
              GROUP BY i.zan11_mold_slip_no) c2 ON a.zau10_slip_no =
                                                   c2.zan11_mold_slip_no
 ORDER BY a.zau10_slip_no DESC
测试发现查询速度快了好多倍,只有0.203秒,查询速度相差129倍
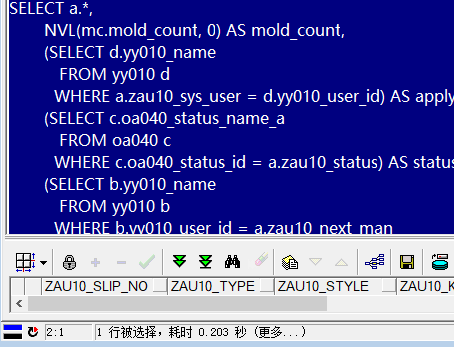
是什么原因导至这种查询速度变慢呢?我们在oracle写查询语句时经常这样写,其实关键点旧写法是zau10被查询出多少记录就要去执行多少次子查询,相当于zau10查出1000条记录就会有1000个子查询,因为他要通过zau10中的记录字段去查询其它了表,有点类似于我们在java中的for循环一个slipno后,然后通过slipno去别一个表查记录,如果原来的列表记录比较多的话,效率会明显的变慢,我们在开发时也要尽量避免这种查询。优化后的写法明显示要好很多,我们先不关联zau10中的记录,只是把别外一个表的记录先分好组为了一个关联,这样可以一次性查询出来,后面zau10要去关联的话直接使用slip_no去关联就行了,也就是说原来的写法我们查询数据库要上千次,后者只需要三次就行了,其它的全是在查询的结果中关联,不需要去扫描表了。
一、子查询相关
| 坑 | 说明 | 正确做法 |
|---|---|---|
| 关联子查询里有 JOIN/GROUP BY/COUNT/SUM | 主表每行执行一次,N 行 = N 次 | 改 LEFT JOIN 预聚合 |
| NOT IN 子查询里有 NULL | 结果集直接变空(全不返回) | 用 NOT EXISTS 或确保子查询列 NOT NULL |
| 标量子查询返回多行 | ORA-01427 | 确认子查询有唯一约束或用 ROWNUM=1 |
| 子查询里用 SELECT * | 列数不匹配直接报错 | 明确写列名 |
二、索引失效
| 坑 | 原因 | 正确做法 |
|---|---|---|
| 索引列包函数 | WHERE TRUNC(date_col) = ... 索引失效 | 改成范围:>= TRUNC(...) AND < TRUNC(...)+1 |
| 隐式类型转换 | WHERE varchar_col = 123 → Oracle 做 TO_NUMBER() 索引失效 | 传参类型跟列一致 |
| 对索引列做运算 | WHERE col * 2 > 100 | 改成 WHERE col > 50 |
| 使用 != / <> / NOT | 大多数情况索引失效 | 改用 col > val OR col < val 或 IN 列表 |
| LIKE '%xxx' 前导通配符 | 索引无法使用 | 改 LIKE 'xxx%' 或建反向索引 |
三、NULL 陷阱
| 坑 | 说明 | 正确做法 |
|---|---|---|
col = NULL | 永远返回 UNKNOWN(0行) | col IS NULL |
col <> NULL | 同上,0行 | col IS NOT NULL |
COUNT(col) vs COUNT(*) | 前者不计 NULL 行 | 确认你要的是哪个 |
NULL 参与计算 | NULL + 1 = NULL | 用 NVL(col, 0) |
NULL 排序位置 | ASC 时 NULL 排最后,DESC 时排最前(可能不符合预期) | ORDER BY col NULLS LAST/FIRST |
四、分页
| 坑 | 说明 | 正确做法 |
|---|---|---|
| 两层嵌套就分页 | 可能排序全量数据再 ROWNUM | 三层嵌套:SELECT * FROM (SELECT t.*, ROWNUM rn FROM (ORDER BY ...) t) |
| ROWNUM 放在 WHERE 里跟 ORDER BY 同层 | 先给 ROWNUM 再排序,顺序乱了 | ORDER BY 必须在最内层 |
SELECT * + ROWNUM 分页 | 列名冲突、网络传输大 | 明确列名 |
五、JOIN 与笛卡尔积
| 坑 | 说明 | 正确做法 |
|---|---|---|
| 忘写 JOIN 条件 | 直接笛卡尔积,行数 = 表A行数 × 表B行数 | 检查每个 JOIN 都有 ON 条件 |
| 多表 JOIN 顺序乱 | CBO 可能选错驱动表 | 小表驱动大表,或加 /*+ LEADING() */ 提示 |
| 外连接 (+) 混用 | Oracle 老语法容易漏条件 | 统一用 LEFT JOIN ... ON |
六、性能相关
| 坑 | 说明 | 正确做法 |
|---|---|---|
| 统计信息过期 | CBO 选错执行计划 | 定期 DBMS_STATS.GATHER_TABLE_STATS |
| 大表全表扫描 | 没索引或索引失效 | 检查执行计划,确认走索引 |
| 深分页(翻到 10000 页) | OFFSET 100000 要扫前 10 万行 | 用"游标分页":WHERE id > :last_id ORDER BY id LIMIT 20 |
| DISTINCT 滥用 | 掩盖数据重复问题,还慢 | 先查为什么有重复,必要时才 DISTINCT |
| UNION 滥用 | 自动去重,代价大 | 不需要去重就用 UNION ALL |
| 子查询返回大结果集再 JOIN | 内存/临时表撑爆 | 加限定条件或分批处理 |
七、Oracle 特有坑
| 坑 | 说明 | 正确做法 |
|---|---|---|
| 空字符串 = NULL | Oracle 里 '' 就是 NULL,跟其他数据库不一样 | 用 IS NULL 判断,别用 = '' |
| 列别名用关键字 | SELECT count AS count → 报错 | 加双引号或换名 |
字符串拼接用 || | 跟其他 DB 的 CONCAT 不同 | 记住 Oracle 用 ||,或 CONCAT(a,b) 只支持两个参数 |
| DATE 类型只有日期没有时间? | 错,DATE 有年月日时分秒 | 别用 TRUNC 以为只是日期 |
| rownum 不能用于 UPDATE/DELETE 子查询直接过滤 | 需要再包一层 | UPDATE t SET ... WHERE id IN (SELECT id FROM (SELECT id, ROWNUM rn FROM t) WHERE rn <= 10) |
八、你这个 SQL 场景的专项注意事项
| 点 | 说明 |
|---|---|
| LEFT JOIN 预聚合适合结果集小的场景 | 如果子表千万级且 GROUP BY 后结果也大,加 IN (SELECT 主表主键 FROM 主表) 限定范围 |
| NVL 兜底 | JOIN 没匹配时返回 NULL,用 NVL 转 0,保持跟原 count(*) 行为一致 |
分页壳里 SELECT * | 确保内层没有重复列名(你之前 ORA-00918 就是这个) |
| 索引必须配套 | LEFT JOIN 的 ON 列、子查询 WHERE 过滤列都要有索引,否则预聚合本身也慢 |
| 执行计划验证 | 改完 SQL 跑 EXPLAIN PLAN 确认走了 HASH JOIN / NESTED LOOP,没出现全表扫 + 笛卡尔积 |
一句话速记
子查询有聚合 → 改 JOIN;索引列别包函数;NULL 用 IS NULL;分页三层套;NOT IN 有 NULL 就炸;统计信息要更新;JOIN 别忘了 ON 条件。